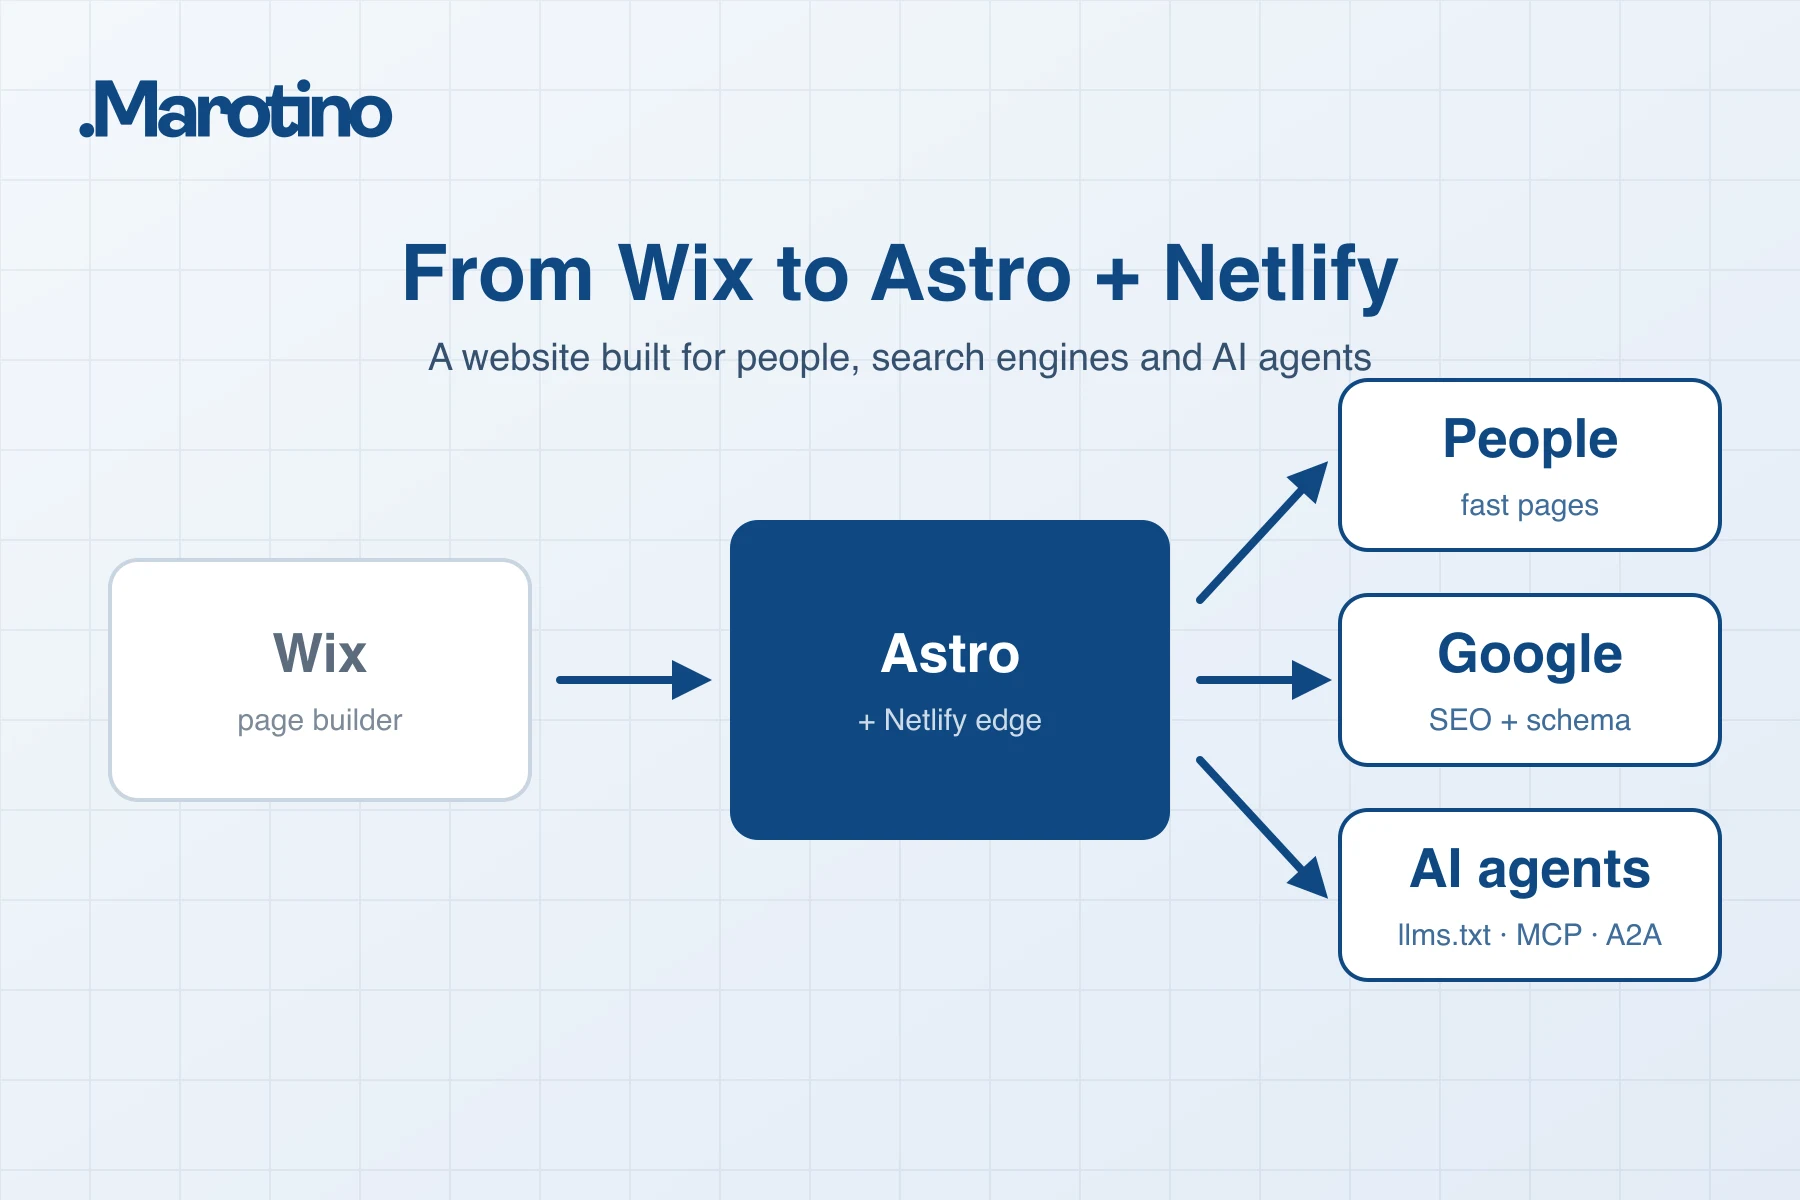
En 2026, la página web de una empresa tiene tres públicos: las personas, los buscadores y los sistemas de IA que responden preguntas en nombre de las personas. Wix atiende bien al primero. Atender a los otros dos exige controlar cada byte que envía la web, y Astro sobre Netlify ofrece precisamente ese control.
Esta es la guía que seguimos en Marotino cuando reconstruimos una web: qué hacer, en qué orden y qué errores cuestan posiciones sin hacer ruido.
A quién va dirigida esta guía: a CTO, directores de marketing y fundadores cuya web en Wix se ha convertido en un canal de crecimiento y que necesitan un plan de migración que puedan entregar a un equipo de ingeniería o con el que contrastar la propuesta de un proveedor.
La respuesta corta
- Por qué migrar: control total sobre el HTML, el rendimiento, los datos estructurados y los archivos que leen los agentes de IA. Wix limita los cuatro.
- Qué es lo más importante: un mapa de redirecciones completo el día del lanzamiento, para que ninguna URL antigua devuelva un 404.
- Qué la hace rápida: páginas servidas desde una CDN (prerrenderizadas, o renderizadas una sola vez y almacenadas en caché), el mínimo de JavaScript e imágenes del tamaño adecuado en formatos modernos.
- Qué hace que Google la entienda: una única entidad de empresa coherente en JSON-LD, un hreflang correcto y sitemaps generados automáticamente.
- Qué hace que los asistentes de IA la citen: contenido que responde primero, en secciones autónomas, junto con versiones limpias y legibles por máquinas de las páginas (
llms.txt, Markdown) y, si se quiere que los agentes actúen, un servidor MCP. - Qué echa a perder la mayoría de las migraciones: las redirecciones que faltan y los cambios de DNS hechos en el orden equivocado.
Cuándo basta con Wix y cuándo no
Wix basta para una web corporativa pequeña, que cambia poco y no compite en los buscadores. Así se lo decimos, sin rodeos, a quienes nos consultan.
Se queda corta cuando se cumple cualquiera de estas condiciones:
- La búsqueda orgánica o los asistentes de IA son un canal real de captación.
- La web se ofrece en varios idiomas y hace falta control total sobre las URLs y el hreflang.
- Se quieren datos estructurados diseñados como un único grafo conectado, o unas Core Web Vitals que se mantengan en «bueno» en móviles de gama media.
- Se quiere que los agentes de IA lean la web, busquen en ella o envíen una consulta.
- Hacen falta integraciones que la plataforma no ofrece: el CRM propio, medición de conversiones en el servidor, un asistente de chat basado en el contenido de la propia empresa.
| Wix | Astro + Netlify | |
|---|---|---|
| HTML y JavaScript que se envían | Definidos por la plataforma | Propios, byte a byte |
| Renderizado | Lo hace la plataforma, con un runtime de JavaScript pesado | Estático o en servidor, en caché en la CDN |
| Datos estructurados | Plantillas predefinidas más JSON-LD personalizado, dentro de los límites de la plataforma | Cualquier schema, generado a partir de los datos propios |
| SEO multilingüe | Integrado, con control limitado | Control total de URLs, hreflang y canonicals |
| Archivos y endpoints para agentes de IA | Lo que genere la plataforma | llms.txt, Markdown, MCP, A2A, cualquier archivo /.well-known |
| Despliegues | Publicación desde el editor | Despliegues desde Git, previsualizaciones por rama, rollbacks instantáneos |
Si busca un socio que se encargue de toda la reconstrucción, esto es el núcleo de nuestro servicio de desarrollo web.
Paso 1: Inventariarlo todo antes de tocar nada
Las URLs antiguas que dejan de funcionar son el principal motivo por el que las migraciones pierden posiciones. El inventario debe estar listo antes de escribir una sola línea de código.
- Exportar todas las URLs que conocen los buscadores. Conviene combinar Search Console, Bing Webmaster Tools, el sitemap actual y un rastreo de la web en producción. La navegación por sí sola deja muchas cosas fuera.
- Asignar a cada URL antigua su nuevo destino. Los artículos del blog de Wix, las páginas dinámicas y los productos de la tienda siguen cada uno su propio patrón. Se mapean patrón a patrón y después se revisan las excepciones a mano.
- Decidir qué se retira. Una página retirada recibe un 301 hacia la página relevante más próxima. Una redirección masiva a la página de inicio suele tratarse como un soft 404, así que las señales de la página se pierden igualmente.
- Registrar la línea base: clics, impresiones y principales consultas por página durante al menos tres meses. Sin ella no hay forma de demostrar que la migración ha funcionado.
En Netlify, las redirecciones se definen en netlify.toml o en _redirects, junto al código, de modo que pasan por revisión de código. Hay dos detalles importantes:
- El orden importa. Se aplica la primera regla que coincide, así que las rutas exactas deben ir antes que las reglas con comodines.
- Los archivos existentes tienen prioridad por defecto. Si existe un archivo en la ruta antigua, Netlify lo sirve e ignora la redirección, salvo que la regla esté marcada con
force = true(un301!en_redirects).
Lista de comprobación
- Cada URL indexada tiene un destino
- No hay cadenas de redirecciones (de A a B y de B a C); cada regla apunta a una URL final que responde 200
- Se cubren las URLs antiguas de imágenes y PDF, no solo las páginas
- Línea base exportada desde Search Console y Bing Webmaster Tools
Paso 2: Que la velocidad sea lo predeterminado, no un proyecto
El rendimiento debe formar parte de la arquitectura, no ajustarse al final. Las Core Web Vitals forman parte de las señales de experiencia en la página de Google y se miden con datos de usuarios reales en el percentil 75 de las visitas. La relevancia sigue pesando más, pero las páginas lentas pierden cuando la competencia está reñida, y además pierden visitantes.
| Métrica | Umbral «bueno» de Google | Nuestro objetivo |
|---|---|---|
| Largest Contentful Paint (LCP) | 2,5 s o menos | menos de 1,8 s |
| Interaction to Next Paint (INP) | 200 ms o menos | menos de 100 ms |
| Cumulative Layout Shift (CLS) | 0,1 o menos | próximo a 0 |
| Time to First Byte (TTFB) | no es una Core Web Vital; la referencia habitual es 0,8 s o menos | menos de 200 ms desde la CDN |
Cómo lo consiguen Astro y Netlify:
- Enviar HTML, no JavaScript. Astro renderiza las páginas en HTML y, por defecto, no envía JavaScript al cliente. Las partes interactivas se convierten en «islas» que cargan únicamente su propio código.
- Almacenar en caché en la CDN. Las páginas prerrenderizadas son archivos estáticos en la CDN de Netlify. Las renderizadas en servidor también pueden almacenarse en caché: se envía
Netlify-CDN-Cache-Controlcon una vida útil larga, cada despliegue la invalida y la caché solo varía según lo que de verdad cambia la página. Por ejemplo,Netlify-Vary: cookie=langmantiene una copia en caché por cada cookie de idioma, en lugar de ninguna. - Sacar de la página en caché la lógica que depende de cada visitante. Todo lo que dependa del visitante, como su país para el banner de cookies, debe ir en una edge function o en un script pequeño, no en el HTML en caché. De lo contrario, el país del primer visitante se sirve a todos los demás.
- Dimensionar las imágenes para su hueco. Las herramientas de imagen de Astro generan AVIF o WebP con las dimensiones correctas y con ancho y alto explícitos, lo que evita la mayoría de los problemas de LCP y CLS.
- Hacerlo obligatorio. Tratamos una puntuación de Lighthouse de 99 o más en las cuatro categorías como requisito para publicar, no como una aspiración. Lighthouse trabaja con datos de laboratorio y no puede medir el INP, por lo que tras el lanzamiento también vigilamos los datos de campo en Search Console.
Paso 3: SEO internacional sin contradicciones
El hreflang indica a Google qué versión lingüística mostrar a cada usuario. Es fácil configurarlo mal sin darse cuenta, porque no hay nada que falle a la vista.
Las reglas que seguimos:
- Cada versión enumera todas las versiones, incluida ella misma, y cada alternativa debe enlazar de vuelta. El hreflang que no es recíproco se ignora. Se añade
x-defaultpara la versión que debe recoger a todos los demás usuarios. - Usar códigos válidos. El idioma en ISO 639-1 (
de), opcionalmente con una región en ISO 3166-1 alfa-2 (es-ES). Una región sola no es válida. - Cada versión lingüística es su propia canónica. Apuntar todos los idiomas a la canónica en inglés le indica a Google que las traducciones son duplicados, y desaparecen del índice.
- Emitir el hreflang desde un único lugar. Un error habitual es un layout que imprime el conjunto completo mientras una plantilla de página imprime el suyo, más corto. Lo más probable es que se ignoren las anotaciones contradictorias.
- Mantener coherentes el sitemap y el head de la página. Cualquiera de los dos métodos funciona; si se usan ambos, deben generarse a partir de un único inventario de rutas para que no puedan desincronizarse.
- Incluir solo páginas que existan. Una página traducida a tres de diez idiomas anuncia solo esos tres. Cada alternativa debe ser una URL indexable que responda 200, no una redirección ni una página con noindex.
Paso 4: Datos estructurados que describan una única entidad real
Los buscadores y los modelos de lenguaje se forman una imagen de la empresa a partir de los datos estructurados. Hay que darles una única imagen coherente, no una docena de fragmentos.
- Definir una sola Organization con un
@idestable (por ejemplo,https://yourdomain.com/#organization) y referenciarla en todas partes en lugar de redefinirla. - Organizar los schemas por capas según el tipo de página:
WebSiteyOrganizationen toda la web,Serviceen las páginas de servicios,ArticleoBlogPostingen los artículos, con unauthorreal ydateModified, yBreadcrumbListen todas las páginas por debajo de la de inicio. - Marcar las preguntas frecuentes por su significado, no por los resultados enriquecidos. El marcado
FAQPagesigue describiendo el contenido con claridad, pero desde 2023 Google solo muestra resultados enriquecidos de FAQ en webs gubernamentales y de salud de referencia. No conviene contar con ellos. - Añadir enlaces
sameAsa perfiles que confirmen quién es la empresa, como LinkedIn, Clutch, GitHub o Crunchbase. - Comprobar que todas las URLs del marcado responden. Un logotipo que devuelve 404 es un detalle menor, y evitable.
- No inventar nunca nada. El marcado de reseñas debe reflejar reseñas reales, y Google no muestra estrellas en las reseñas que una empresa publica sobre sí misma. Un marcado engañoso puede acarrear una acción manual.
- Validar todas las plantillas, no solo la página de inicio, con Rich Results Test y el validador de Schema.org.
Paso 5: Escribir contenido que la IA pueda citar
Los asistentes de IA recuperan páginas de forma muy parecida a los buscadores y después citan fragmentos. Los fragmentos claros y autónomos son los que acaban citados.
- Responder primero. La respuesta directa va en las primeras una o dos frases bajo cada encabezado; después, los detalles.
- Usar encabezados que coincidan con preguntas reales, como «¿Cuánto tarda una migración de Wix a Astro?»
- Mantener las secciones autónomas. Un fragmento extraído de la página debe seguir teniendo sentido.
- Priorizar tablas y listas para comparativas, pasos y especificaciones.
- Ser concreto. «Las páginas se almacenan en caché en la CDN hasta el siguiente despliegue» es citable; «un rendimiento ultrarrápido» no lo es.
- Mostrar una autoría real y un
dateModifiedreal, que solo cambie cuando el contenido haya cambiado de verdad.
Dos añadidos facilitan que los modelos de lenguaje consuman el contenido:
/llms.txt: un archivo Markdown en la raíz de la web con el nombre de la empresa, un breve resumen y enlaces comentados a las páginas clave. Es una propuesta comunitaria de 2024, no un estándar, y ningún buscador importante ha dicho que lo utilice para el posicionamiento. Lo añadimos porque cuesta poco y ofrece un mapa preciso a los agentes que lo consultan. Debe generarse a partir del mismo inventario de rutas que el sitemap.- Versiones de las páginas en Markdown: se devuelve el contenido principal, sin navegación ni pie de página, cuando un cliente envía
Accept: text/markdown, o en una URL paralela.md. Con negociación de contenido, hay que enviarVary: Acceptpara que la CDN nunca sirva Markdown a los navegadores.
Paso 6: Preparar la web para los agentes
Primero, legible; después, utilizable. Los agentes de IA actúan cada vez más en nombre de las personas: comparan proveedores, comprueban detalles y envían consultas. Un pequeño conjunto de protocolos abiertos les permite hacerlo en su web sin recurrir al scraping.
| Capa | Qué hace | Esfuerzo |
|---|---|---|
robots.txt con reglas para rastreadores de IA y Content Signals | Declara qué rastreadores son bienvenidos y si el contenido puede usarse para búsqueda, respuestas de IA o entrenamiento | Horas |
Cabeceras Link (RFC 8288) y /.well-known/api-catalog (RFC 9727) | Indica a los agentes dónde están los endpoints legibles por máquinas | Horas |
| Servidor MCP | Permite a los asistentes buscar entre sus servicios y casos de éxito, y enviar una consulta a través del formulario real | Días |
| Agente A2A | Permite que otros agentes hablen con su propio asistente, el que está detrás del chat de la web | Días |
| WebMCP | Expone las mismas herramientas dentro de la página, para agentes que manejan un navegador | Horas, una vez que existe el MCP |
Agent skills y un ai-catalog ARD | Un índice único que recoge todo lo anterior | Horas |
| DNS-AID con DNSSEC | Registros DNS firmados que dirigen a los agentes hacia sus endpoints | Horas, si se hace con cuidado |
En una línea cada uno: MCP (Model Context Protocol, presentado por Anthropic en 2024) permite a los asistentes de IA invocar herramientas por HTTP. A2A (Agent2Agent, impulsado por Google y ahora en la Linux Foundation) permite que los agentes se comuniquen entre sí, cada uno descrito por una Agent Card. WebMCP es una propuesta temprana de un grupo comunitario del W3C para que las páginas registren herramientas ante agentes integrados en el navegador; debe tratarse como experimental. DNS-AID es un borrador del IETF para publicar endpoints de agentes en el DNS, algo que solo resulta fiable con DNSSEC.
Tres reglas mantienen esta capa honesta:
- Cada manifiesto debe describir algo que funcione. Una tarjeta que enumera herramientas sin un servidor detrás es peor que no tenerla.
- Reutilizar una única fuente de verdad. Las herramientas MCP,
llms.txty los sitemaps deben leer del mismo inventario de rutas. - Mantener las acciones de escritura en los canales existentes. Una consulta enviada por un agente debe pasar por el mismo formulario, el mismo filtro antispam y el mismo flujo del CRM que la de una persona.
El escáner gratuito de Cloudflare en isitagentready.com muestra en qué punto está una web. Comprobaciones como los pagos y OAuth se aplican sobre todo a tiendas y aplicaciones con inicio de sesión; una empresa de servicios puede alcanzar el nivel más alto sin ellas. Si quiere un asistente o un agente detrás de estos endpoints, eso es lo que desarrolla nuestro equipo de agentes de IA.
Paso 7: Analítica y consentimiento que no fallen
Una migración es el momento de corregir la medición, no de arrastrar sus problemas.
- Consent Mode v2 por región. «denied» por defecto en el EEE, el Reino Unido y Suiza, donde Google exige consentimiento para la medición y la personalización de anuncios, y lo que marque la legislación local en el resto. Una edge function de Netlify puede leer el país del visitante y fijar los valores predeterminados antes de que se cargue ninguna etiqueta.
- Contabilizar los leads en el servidor. Que un formulario se haya «enviado» en el navegador no significa que se haya guardado. La conversión debe dispararse desde el webhook del formulario, una vez guardado el envío, y enviarse después a GA4 (Measurement Protocol) y a Google Ads (conversiones offline o mejoradas). También hay que transmitir el estado del consentimiento: que se haga en el servidor no significa que no haga falta consentimiento.
- Sacar los scripts de terceros de la ruta crítica. Deben cargarse cuando la página ya sea utilizable. Un solo widget de chat cargado demasiado pronto puede echar por tierra el trabajo de INP del Paso 2.
Paso 8: Montar un pipeline de indexación
- Dividir los sitemaps por sección (páginas, casos de éxito, blog) bajo un único índice de sitemaps. Deben generarse automáticamente, con fechas
lastmodprecisas. Google ignorapriorityychangefreq, y solo se fía delastmodcuando es preciso de forma sistemática. - Notificar a IndexNow en cada despliegue a producción, para que Bing, Yandex, Seznam, Naver y los demás buscadores participantes conozcan los cambios en cuestión de minutos. Google no usa IndexNow; se basa en los sitemaps y en el rastreo.
- Enviar los nuevos sitemaps en Search Console y Bing Webmaster Tools el día del lanzamiento.
- Vigilar los informes durante cuatro a ocho semanas: indexación de páginas, errores de hreflang y de datos estructurados, y las consultas de las páginas principales frente a la línea base del Paso 1.
Paso 9: El día de la migración y el DNS
La mayor parte del riesgo se concentra en una hora de cambios de DNS. Hay que planificarla como un lanzamiento a producción, con un runbook y un plan de marcha atrás.
- Reducir los TTL uno o dos días antes, para poder corregir errores en minutos, no en horas.
- Copiar todos los registros DNS, no solo los de la web. El correo (MX, SPF, DKIM, DMARC), los registros de verificación y los subdominios del CRM o del chat deben existir en el nuevo proveedor antes de cambiar los servidores de nombres.
- Revisar los reenvíos de URL. Los registradores suelen implementar el «reenvío de este subdominio» con sus propios servidores. Hay que recrearlos como reglas de redirección antes del cambio o desaparecerán.
- Apuntar el dominio a Netlify de la forma admitida. Netlify DNS o, en un proveedor externo, un registro ALIAS, ANAME o con CNAME flattening para el dominio raíz (apex) y un CNAME para
www. - No colocar una segunda CDN delante de Netlify. Netlify lo desaconseja: añade una caché que hay que purgar por separado, oculta la ubicación del visitante a las edge functions y puede impedir la renovación de certificados. Los registros de la web deben configurarse en modo solo DNS.
- Gestionar DNSSEC en el orden correcto. Si la zona antigua está firmada, se elimina su registro DS en el registrador y se deja que caduque el TTL del DS antes de cambiar los servidores de nombres. En el nuevo proveedor, primero se activa la firma, se espera al menos el TTL más largo de la zona y solo entonces se añade el nuevo registro DS en el registrador. Añadirlo demasiado pronto rompe la resolución para todos los usuarios que estén detrás de un resolver con validación.
- Probar desde fuera de la propia red, porque el ordenador guarda en caché respuestas antiguas. Después, rastrear la lista de URLs antiguas y confirmar que cada una devuelve un 301 hacia un 200.
Los errores que vemos con más frecuencia
- Redirigir todas las páginas retiradas a la página de inicio.
- Redirecciones que nunca se ejecutan porque sigue existiendo un archivo antiguo en la misma ruta.
- Dos conjuntos de hreflang en la misma página, o alternativas que no enlazan de vuelta.
- Todas las versiones lingüísticas con la canónica apuntando al inglés.
- Schema que hace referencia a imágenes o páginas que no existen.
- Páginas renderizadas en servidor sin caché en la CDN, o datos de cada visitante incrustados en una página en caché.
- Manifiestos de agentes que describen herramientas que nunca se llegaron a desarrollar.
- DNS cambiado antes de que la nueva zona estuviera completa, o un registro DS obsoleto olvidado en el registrador.
Cómo se aplica en la práctica
Reconstruimos nuestra propia web, marotino.com, pasándola de Wix a Astro y Netlify con esta guía. Hoy ofrece 19 idiomas y unas 1500 URLs indexables desde sitemaps generados, con las páginas en caché en la CDN de Netlify y una notificación a IndexNow en cada despliegue.
Para las máquinas, publica llms.txt y versiones en Markdown de sus páginas, tiene en marcha un servidor MCP en /mcp y un agente A2A en /a2a conectado al mismo asistente que el chat de la web. También expone herramientas WebMCP, un ai-catalog ARD y registros DNS-AID firmados con DNSSEC. El escáner isitagentready.com de Cloudflare la califica como «Agent-Native», el nivel más alto.
En cuanto a la medición, Consent Mode v2 se aplica por región y las conversiones de leads se envían desde el servidor a partir del webhook del formulario.
Aplicamos el mismo enfoque a las webs de nuestros clientes, desde empresas de servicios hasta tiendas online; puede verlo en nuestros proyectos.
FAQ
¿Cuánto tarda una migración de Wix a Astro?
La web típica de una empresa tarda unas pocas semanas desde el inventario hasta el lanzamiento. Las variables principales son el número de páginas e idiomas, cuánto contenido hay que reescribir y las integraciones necesarias, como el CRM, los formularios, la analítica y el chat. La capa preparada para agentes añade días, no semanas.
¿Perderé mis posiciones en Google al dejar Wix?
No, siempre que cada URL antigua tenga una redirección 301 a su equivalente nueva más próxima y el contenido sea al menos igual de bueno. Es normal que haya fluctuaciones durante unas semanas mientras Google vuelve a rastrear la web. Una caída sostenida casi siempre se debe a redirecciones que faltan, contenido perdido o hreflang y canonicals mal configurados.
¿Puede mi equipo seguir editando el contenido sin un desarrollador?
Sí. Astro funciona con CMS headless y con archivos Markdown en Git, que se editan desde una interfaz web sencilla. Cada cambio tiene una vista previa antes de publicarse.
¿Es Netlify caro en comparación con Wix?
Para la mayoría de las webs corporativas, el coste del alojamiento es similar o inferior. El coste principal es la propia reconstrucción, que depende del alcance. Nuestra guía de costes explica de qué depende.
¿Qué es llms.txt y lo necesito?
llms.txt es una propuesta de archivo Markdown situado en la raíz de una web que resume la empresa y enlaza a sus páginas clave, para que los modelos de lenguaje y los agentes puedan entender la web sin rastrearla entera. No es un estándar oficial, y ningún buscador importante ha confirmado que lo utilice para el posicionamiento. Requiere poco esfuerzo, así que lo tratamos como un añadido de bajo coste, no como una táctica de posicionamiento.
¿Qué es un servidor MCP en una página web?
MCP (Model Context Protocol) es un protocolo abierto que permite a los asistentes de IA utilizar herramientas. El servidor MCP de una web permite a un asistente buscar entre sus servicios y casos de éxito y, cuando el usuario lo solicita, enviarle una consulta a través de su formulario de contacto real, sin hacer scraping de sus páginas.
¿Quiere esto para su web?
Planificamos y ejecutamos migraciones como esta de principio a fin: inventario y redirecciones, diseño, contenido, SEO, analítica y la capa preparada para agentes. Cuéntenos cómo es su web y le responderemos con un plan.