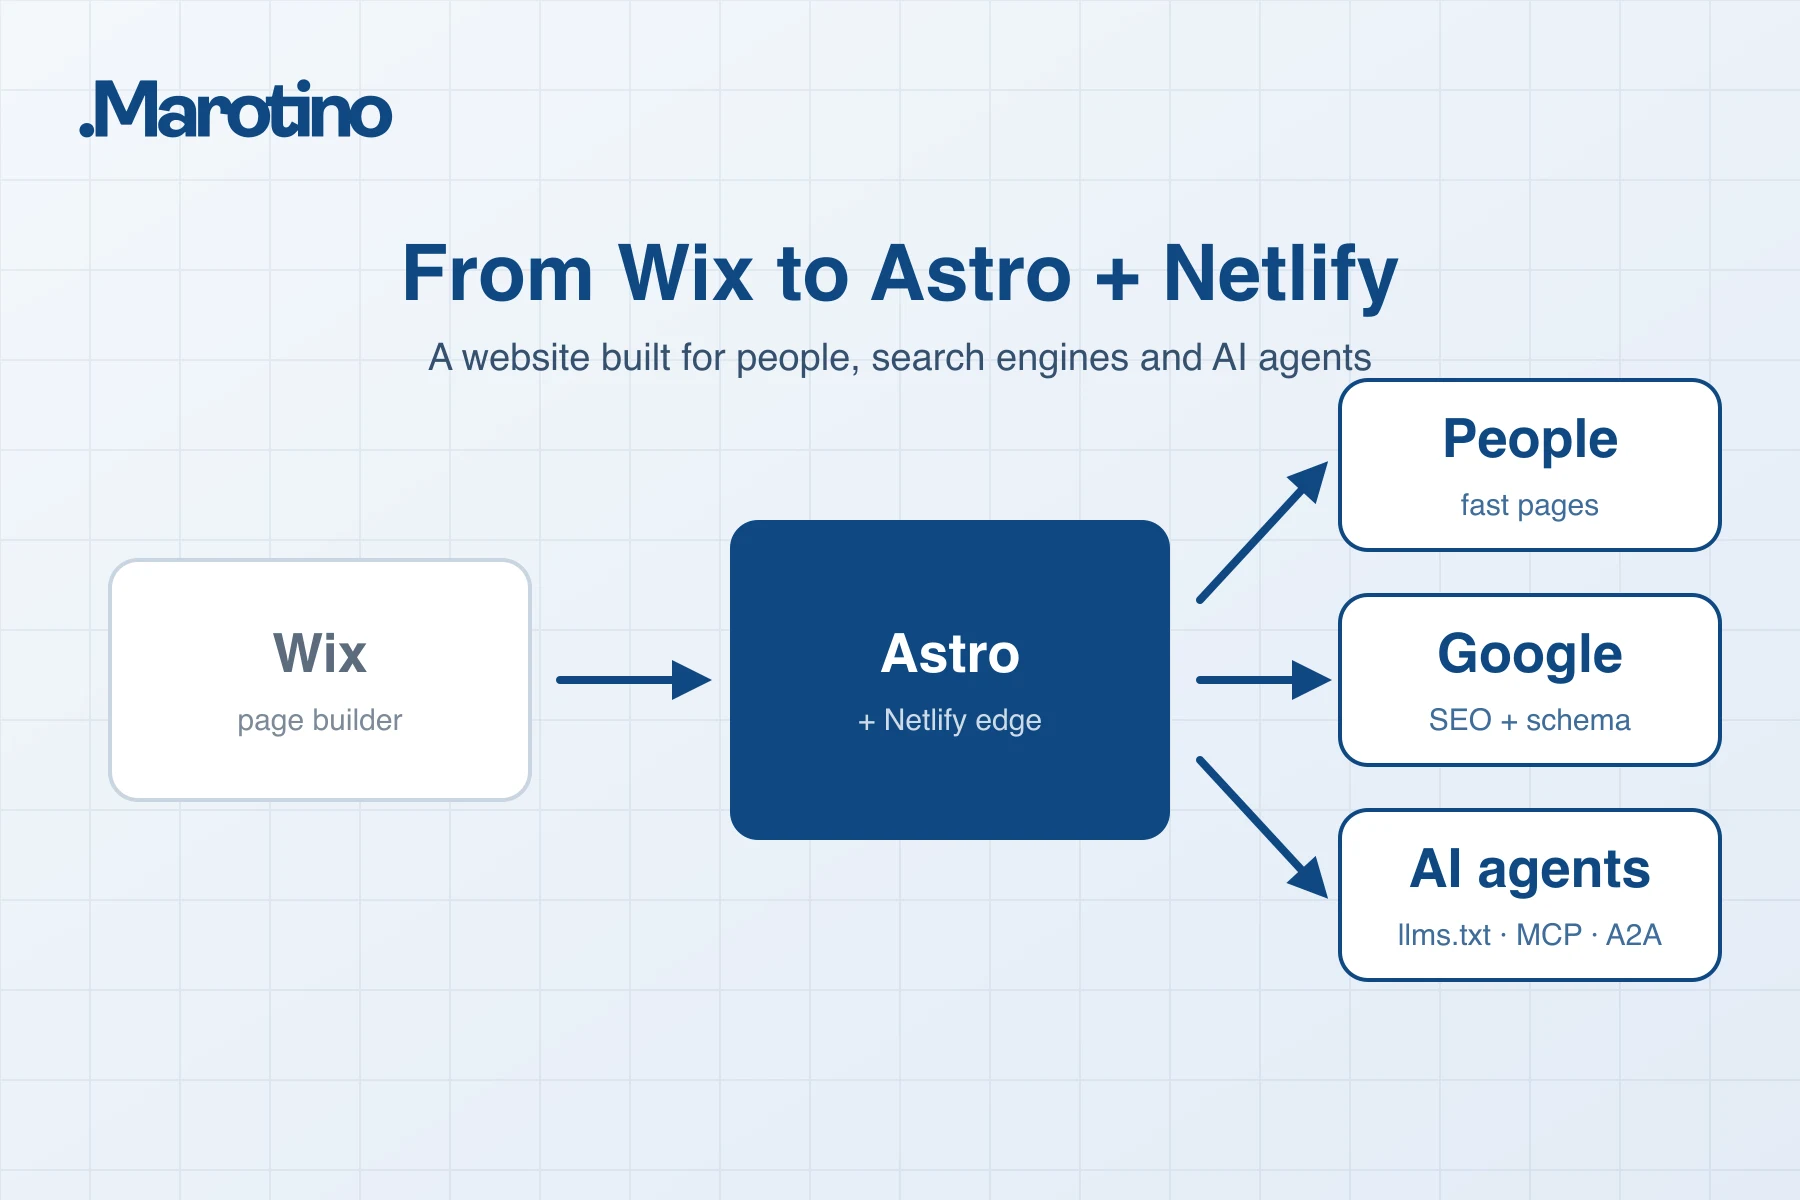
Strona firmowa w 2026 roku ma trzech odbiorców: ludzi, wyszukiwarki i systemy AI, które odpowiadają ludziom na pytania. Wix dobrze obsługuje pierwszą grupę. Żeby obsłużyć dwie pozostałe, trzeba kontrolować każdy bajt wysyłany przez stronę – a Astro na Netlify daje właśnie taką kontrolę.
Oto playbook, według którego pracujemy w Marotino przy przebudowie stron: co zrobić, w jakiej kolejności i jakie błędy po cichu kosztują pozycje w wyszukiwarce.
Dla kogo jest ten przewodnik: dla CTO, dyrektorów marketingu i założycieli firm, dla których strona na Wix stała się kanałem wzrostu i którzy potrzebują planu migracji – takiego, który można przekazać zespołowi deweloperskiemu albo według którego można zweryfikować wykonawcę.
W skrócie
- Po co migrować: pełna kontrola nad HTML, wydajnością, danymi strukturalnymi i plikami, które czytają agenci AI. Wix ogranicza wszystkie cztery obszary.
- Co jest najważniejsze: kompletna mapa przekierowań w dniu startu, tak aby żaden stary adres URL nie zwracał 404.
- Co zapewnia szybkość: strony serwowane z CDN (prerenderowane albo renderowane raz i trzymane w cache), minimum JavaScriptu oraz obrazy w nowoczesnych formatach i właściwych rozmiarach.
- Dzięki czemu Google rozumie stronę: jedna spójna encja firmy w JSON-LD, poprawny hreflang i generowane mapy witryny.
- Dzięki czemu asystenci AI ją cytują: treści zaczynające się od odpowiedzi, podzielone na samodzielne sekcje, do tego czyste, czytelne dla maszyn wersje stron (
llms.txt, Markdown), a jeśli chcesz, żeby agenci mogli wykonywać działania – także serwer MCP. - Co psuje większość migracji: brakujące przekierowania i zmiany DNS wykonane w złej kolejności.
Kiedy Wix wystarczy, a kiedy już nie
Wix wystarczy małej stronie wizytówce, która rzadko się zmienia i nie konkuruje w wyszukiwarce. Mówimy to potencjalnym klientom wprost.
Wyrastasz z niego, gdy spełniony jest którykolwiek z tych warunków:
- Wyszukiwanie organiczne lub asystenci AI są realnym kanałem pozyskiwania klientów.
- Obsługujesz kilka języków i potrzebujesz pełnej kontroli nad adresami URL i hreflang.
- Chcesz danych strukturalnych zaprojektowanych jako jeden powiązany graf albo Core Web Vitals, które pozostają „dobre” na telefonach ze średniej półki.
- Chcesz, żeby agenci AI czytali Twoją stronę, przeszukiwali ją lub wysyłali Ci zapytania.
- Potrzebujesz rozwiązań, których platforma nie oferuje: integracji z Twoim CRM, śledzenia konwersji po stronie serwera, asystenta czatu opartego na Twoich własnych treściach.
| Wix | Astro + Netlify | |
|---|---|---|
| Wysyłany HTML i JavaScript | Określony przez platformę | Twój, co do bajtu |
| Renderowanie | Po stronie platformy, z ciężkim runtime’em JavaScriptu | Statyczne lub po stronie serwera, z cache na CDN |
| Dane strukturalne | Gotowe presety i własny JSON-LD w granicach platformy | Dowolne schematy generowane z Twoich własnych danych |
| SEO wielojęzyczne | Wbudowane, z ograniczoną kontrolą | Pełna kontrola nad adresami URL, hreflang i tagami canonical |
| Pliki i endpointy dla agentów AI | To, co wygeneruje platforma | llms.txt, Markdown, MCP, A2A, dowolny plik /.well-known |
| Wdrożenia | Publikacja z edytora | Wdrożenia z Gita, podgląd dla każdej gałęzi, natychmiastowy rollback |
Jeśli szukasz partnera, który przeprowadzi całą przebudowę, to właśnie sedno naszej usługi tworzenia stron internetowych.
Krok 1: Zinwentaryzuj wszystko, zanim cokolwiek ruszysz
Stare adresy URL, które przestają działać, to przyczyna numer jeden spadków pozycji po migracji. Zrób inwentaryzację, zanim napiszesz pierwszą linijkę kodu.
- Wyeksportuj każdy URL, który znają wyszukiwarki. Połącz dane z Search Console, Bing Webmaster Tools, obecnej mapy witryny i crawla działającej strony. Sama nawigacja wiele pomija.
- Przypisz każdemu staremu adresowi nowe miejsce. Wpisy bloga na Wix, strony dynamiczne i produkty sklepu mają własne wzorce adresów. Mapuj je wzorzec po wzorcu, a potem ręcznie sprawdź wyjątki.
- Zdecyduj, co wycofujesz. Wycofana strona dostaje 301 do najbliższej tematycznie strony. Masowe przekierowanie na stronę główną jest zwykle traktowane jak soft 404, więc sygnały tej strony i tak przepadają.
- Zapisz punkt odniesienia: kliknięcia, wyświetlenia i główne zapytania dla każdej strony z co najmniej trzech miesięcy. Bez niego nie udowodnisz, że migracja się udała.
W Netlify przekierowania definiuje się w netlify.toml lub _redirects, razem z kodem, więc przechodzą code review. Liczą się dwa szczegóły:
- Kolejność ma znaczenie. Wygrywa pierwsza pasująca reguła, więc dokładne ścieżki umieszczaj przed regułami z symbolami wieloznacznymi.
- Istniejące pliki mają domyślnie pierwszeństwo. Jeśli pod starą ścieżką istnieje plik, Netlify go serwuje i ignoruje przekierowanie, chyba że reguła ma ustawione
force = true(w_redirectszapis301!).
Checklista
- Każdy zaindeksowany URL ma adres docelowy
- Brak łańcuchów przekierowań (A → B → C); każda reguła prowadzi wprost do docelowego URL-a zwracającego 200
- Uwzględnione stare adresy obrazów i PDF-ów, nie tylko stron
- Punkt odniesienia wyeksportowany z Search Console i Bing Webmaster Tools
Krok 2: Szybkość jako standard, a nie osobny projekt
Wbuduj wydajność w architekturę, zamiast dostrajać ją na końcu. Core Web Vitals są częścią sygnałów page experience w Google i mierzy się je na danych z rzeczywistych wizyt, na 75. percentylu. Trafność nadal waży więcej, ale przy wyrównanej rywalizacji wolne strony przegrywają – i tracą odwiedzających.
| Metryka | Próg „dobry” według Google | Nasz cel |
|---|---|---|
| Largest Contentful Paint (LCP) | 2,5 s lub mniej | poniżej 1,8 s |
| Interaction to Next Paint (INP) | 200 ms lub mniej | poniżej 100 ms |
| Cumulative Layout Shift (CLS) | 0,1 lub mniej | blisko 0 |
| Time to First Byte (TTFB) | nie należy do Core Web Vitals; typowa wytyczna to 0,8 s lub mniej | poniżej 200 ms z CDN |
Jak Astro i Netlify to osiągają:
- Wysyłaj HTML, nie JavaScript. Astro renderuje strony do HTML i domyślnie nie wysyła żadnego JavaScriptu po stronie klienta. Interaktywne elementy stają się „wyspami”, które ładują wyłącznie własny kod.
- Cache na CDN. Prerenderowane strony to statyczne pliki w CDN Netlify. Strony renderowane na serwerze też można cache’ować: wysyłaj
Netlify-CDN-Cache-Controlz długim czasem życia, niech każde wdrożenie unieważnia cache, a cache różnicuj wyłącznie według tego, co naprawdę zmienia stronę. Na przykładNetlify-Vary: cookie=langprzechowuje osobną kopię dla każdej wartości ciasteczka językowego, zamiast nie cache’ować strony wcale. - Trzymaj logikę zależną od odwiedzającego poza stroną w cache. Wszystko, co zależy od odwiedzającego, na przykład jego kraj na potrzeby banera cookies, powinno trafić do edge function lub małego skryptu, a nie do HTML w cache. W przeciwnym razie kraj pierwszego odwiedzającego zobaczą wszyscy.
- Dopasuj rozmiar obrazów do miejsca na stronie. Narzędzia do obrazów w Astro generują AVIF lub WebP w odpowiednich wymiarach, z jawnie podaną szerokością i wysokością, co zapobiega większości problemów z LCP i CLS.
- Egzekwuj to. Wynik Lighthouse 99 lub wyższy we wszystkich czterech kategoriach traktujemy jako warunek wydania, a nie ambicję. Lighthouse to dane laboratoryjne i nie mierzy INP, dlatego po starcie śledzimy też dane z rzeczywistych wizyt w Search Console.
Krok 3: Międzynarodowe SEO bez sprzeczności
Hreflang wskazuje Google, którą wersję językową pokazać któremu użytkownikowi. Łatwo o subtelny błąd, bo nic nie psuje się w widoczny sposób.
Zasady, których przestrzegamy:
- Każda wersja wymienia wszystkie wersje, łącznie z samą sobą, a każda wersja alternatywna musi odsyłać z powrotem. Hreflang bez wzajemnych odwołań jest ignorowany. Dodaj
x-defaultdla wersji, która ma obsłużyć wszystkich pozostałych użytkowników. - Używaj poprawnych kodów. Język według ISO 639-1 (
de), opcjonalnie z regionem według ISO 3166-1 alpha-2 (es-ES). Sam kod regionu jest niepoprawny. - Każda wersja językowa wskazuje samą siebie jako kanoniczną. Jeśli wszystkie języki wskazują angielski canonical, Google uznaje tłumaczenia za duplikaty i wypadają one z indeksu.
- Generuj hreflang w jednym miejscu. Częsty błąd: layout wypisuje pełny zestaw, a szablon strony – własny, krótszy. Sprzeczne adnotacje najpewniej zostaną zignorowane.
- Dbaj o zgodność mapy witryny i sekcji head. Obie metody są poprawne; jeśli używasz obu, generuj je z jednego inwentarza tras, żeby nie mogły się rozjechać.
- Wymieniaj tylko strony, które istnieją. Strona przetłumaczona na trzy z dziesięciu języków deklaruje tylko te trzy. Każda wersja alternatywna musi być indeksowalnym adresem URL zwracającym 200, a nie przekierowaniem ani stroną z noindex.
Krok 4: Dane strukturalne opisujące jedną rzeczywistą encję
Wyszukiwarki i modele językowe składają obraz Twojej firmy z danych strukturalnych. Daj im jeden spójny obraz, a nie tuzin fragmentów.
- Zdefiniuj jeden obiekt Organization ze stałym
@id(na przykładhttps://yourdomain.com/#organization) i odwołuj się do niego wszędzie, zamiast definiować go od nowa. - Nakładaj schematy warstwowo według typu strony:
WebSiteiOrganizationw całym serwisie,Servicena stronach usług,ArticlelubBlogPostingwe wpisach z prawdziwymauthoridateModifiedorazBreadcrumbListna każdej stronie poniżej strony głównej. - Oznaczaj FAQ ze względu na semantykę, a nie wyniki rozszerzone. Znaczniki
FAQPagenadal jasno opisują treść, ale od 2023 roku Google pokazuje wyniki rozszerzone FAQ tylko autorytatywnym serwisom rządowym i medycznym. Nie licz na nie. - Dodaj linki
sameAsdo profili, które potwierdzają, kim jesteś, na przykład LinkedIn, Clutch, GitHub czy Crunchbase. - Sprawdź, czy każdy URL w znacznikach działa. Logo zwracające 404 to drobiazg, ale łatwy do uniknięcia.
- Niczego nie zmyślaj. Znaczniki opinii muszą odzwierciedlać prawdziwe opinie, a Google nie pokazuje gwiazdek przy opiniach, które firma publikuje sama o sobie. Wprowadzające w błąd znaczniki mogą skończyć się ręcznym działaniem.
- Waliduj każdy szablon, nie tylko stronę główną, w Rich Results Test i walidatorze Schema.org.
Krok 5: Pisz treści, które AI może cytować
Asystenci AI pobierają strony podobnie jak wyszukiwarki, a potem cytują fragmenty. Cytowane są fragmenty jasne i zrozumiałe bez kontekstu.
- Najpierw odpowiedź. Umieść bezpośrednią odpowiedź w pierwszym lub drugim zdaniu pod każdym nagłówkiem, a dopiero potem szczegóły.
- Stosuj nagłówki odpowiadające prawdziwym pytaniom, na przykład „Ile trwa migracja z Wix na Astro?”.
- Pisz samodzielne sekcje. Fragment wyjęty ze strony nadal powinien mieć sens.
- Wybieraj tabele i listy do porównań, kroków i specyfikacji.
- Bądź konkretny. „Strony są trzymane w cache na CDN do następnego wdrożenia” da się zacytować; „błyskawiczna wydajność” już nie.
- Podawaj prawdziwego autora i prawdziwe
dateModified, zmieniane tylko wtedy, gdy treść faktycznie się zmieniła.
Dwa dodatki ułatwiają modelom językowym korzystanie z treści:
/llms.txt: plik Markdown w katalogu głównym strony z nazwą firmy, krótkim podsumowaniem i opisanymi linkami do kluczowych stron. To propozycja społeczności z 2024 roku, a nie standard, i żadna duża wyszukiwarka nie ogłosiła, że bierze go pod uwagę w rankingu. Dodajemy go, bo kosztuje niewiele, a agentom, które go pobierają, daje dokładną mapę strony. Generuj go z tego samego inwentarza tras co mapy witryny.- Wersje stron w Markdown: zwracaj główną treść bez nawigacji i stopki, gdy klient wysyła
Accept: text/markdown, albo pod równoległym adresem.md. Przy negocjacji treści wysyłajVary: Accept, żeby CDN nigdy nie serwował Markdownu przeglądarkom.
Krok 6: Przygotuj stronę na agentów AI
Po czytelności czas na użyteczność. Agenci AI coraz częściej działają w imieniu ludzi: porównują dostawców, sprawdzają szczegóły i wysyłają zapytania. Niewielki zestaw otwartych protokołów pozwala im robić to na Twojej stronie bez scrapowania.
| Warstwa | Co robi | Nakład pracy |
|---|---|---|
robots.txt z regułami dla crawlerów AI i Content Signals | Określa, które crawlery są mile widziane i czy treść może służyć do wyszukiwania, odpowiedzi AI lub trenowania modeli | Godziny |
Nagłówki Link (RFC 8288) i /.well-known/api-catalog (RFC 9727) | Wskazuje agentom, gdzie są Twoje endpointy czytelne dla maszyn | Godziny |
| Serwer MCP | Pozwala asystentom przeszukiwać Twoje usługi i case studies oraz wysłać zapytanie przez Twój prawdziwy formularz | Dni |
| Agent A2A | Pozwala innym agentom rozmawiać z Twoim asystentem – tym, który stoi za czatem na stronie | Dni |
| WebMCP | Udostępnia te same narzędzia wewnątrz strony agentom obsługującym przeglądarkę | Godziny, gdy MCP już działa |
Agent skills i ai-catalog ARD | Jeden indeks, który wymienia wszystko powyższe | Godziny |
| DNS-AID z DNSSEC | Podpisane rekordy DNS kierujące agentów do Twoich endpointów | Godziny, przy starannym wykonaniu |
Każdy z nich w jednym zdaniu: MCP (Model Context Protocol, wprowadzony przez Anthropic w 2024 roku) pozwala asystentom AI wywoływać narzędzia przez HTTP. A2A (Agent2Agent, zapoczątkowany przez Google, obecnie rozwijany w Linux Foundation) pozwala agentom komunikować się z innymi agentami, z których każdy jest opisany przez Agent Card. WebMCP to wczesna propozycja grupy społecznościowej W3C, dzięki której strony rejestrują narzędzia dla agentów działających w przeglądarce; traktuj ją jako eksperymentalną. DNS-AID to szkic IETF opisujący publikowanie endpointów agentów w DNS – wiarygodne tylko z DNSSEC.
Trzy zasady, dzięki którym ta warstwa pozostaje uczciwa:
- Każdy manifest musi opisywać coś, co działa. Karta wymieniająca narzędzia, za którymi nie stoi żaden serwer, jest gorsza niż brak karty.
- Korzystaj z jednego źródła prawdy. Narzędzia MCP,
llms.txti mapy witryny powinny czerpać z tego samego inwentarza tras. - Operacje zapisu prowadź istniejącymi ścieżkami. Zapytanie wysłane przez agenta powinno przejść przez ten sam formularz, filtr antyspamowy i drogę do CRM co zapytanie od człowieka.
Darmowy skaner Cloudflare na isitagentready.com pokazuje, na jakim etapie jest strona. Testy takie jak płatności i OAuth dotyczą głównie sklepów i aplikacji z logowaniem; firma usługowa może osiągnąć najwyższy poziom bez nich. Jeśli chcesz, żeby za tymi endpointami stał asystent lub agent, właśnie to buduje nasz zespół agentów AI.
Krok 7: Analityka i zgody, które się nie psują
Migracja to moment, żeby naprawić śledzenie, a nie przenosić jego problemy.
- Consent Mode v2 według regionu. Domyślnie ustawiaj „denied” w EOG, Wielkiej Brytanii i Szwajcarii, gdzie Google wymaga zgody na pomiar i personalizację reklam, a gdzie indziej stosuj się do lokalnych przepisów. Edge function w Netlify może odczytać kraj odwiedzającego i ustawić wartości domyślne, zanim załaduje się jakikolwiek tag.
- Licz leady na serwerze. Formularz, który „wysłał się” w przeglądarce, wcale nie musiał zostać zapisany. Wyzwalaj konwersję z webhooka formularza dopiero po zapisaniu zgłoszenia, a potem wysyłaj ją do GA4 (Measurement Protocol) i Google Ads (konwersje offline lub konwersje rozszerzone). Przekazuj też stan zgody: po stronie serwera nie znaczy bez zgody.
- Trzymaj skrypty zewnętrzne poza ścieżką krytyczną. Ładuj je dopiero wtedy, gdy strona jest już używalna. Jeden widżet czatu załadowany zbyt wcześnie potrafi zniweczyć pracę nad INP z kroku 2.
Krok 8: Zbuduj pipeline indeksowania
- Podziel mapy witryny według sekcji (strony, case studies, blog) pod jednym indeksem map witryny. Generuj je automatycznie, z dokładnymi datami
lastmod. Google ignorujepriorityichangefreq, alastmodufa tylko wtedy, gdy jest konsekwentnie dokładne. - Pinguj IndexNow przy każdym wdrożeniu produkcyjnym, żeby Bing, Yandex, Seznam, Naver i inne uczestniczące wyszukiwarki dowiadywały się o zmianach w ciągu minut. Google nie korzysta z IndexNow; opiera się na mapach witryny i crawlowaniu.
- Prześlij nowe mapy witryny w Search Console i Bing Webmaster Tools w dniu startu.
- Obserwuj raporty przez cztery do ośmiu tygodni: indeksowanie stron, błędy hreflang i danych strukturalnych oraz zapytania Twoich najważniejszych stron na tle punktu odniesienia z kroku 1.
Krok 9: Dzień migracji i DNS
Większość ryzyka skupia się w jednej godzinie zmian DNS. Zaplanuj ją jak wydanie produkcyjne, z runbookiem i planem wycofania.
- Obniż TTL dzień lub dwa wcześniej, żeby błędy dało się poprawić w ciągu minut, a nie godzin.
- Skopiuj wszystkie rekordy DNS, nie tylko te dotyczące strony. Poczta (MX, SPF, DKIM, DMARC), rekordy weryfikacyjne i subdomeny CRM czy czatu muszą istnieć u nowego dostawcy, zanim przełączysz serwery nazw.
- Sprawdź przekierowania URL. Rejestratorzy często realizują opcję „przekieruj tę subdomenę” na własnych serwerach. Odtwórz takie przekierowania jako reguły przed przełączeniem, inaczej znikną.
- Skieruj domenę na Netlify w obsługiwany sposób. Użyj Netlify DNS albo, u zewnętrznego dostawcy, rekordu ALIAS, ANAME lub spłaszczonego rekordu dla domeny głównej (apex) i CNAME dla
www. - Nie stawiaj drugiego CDN przed Netlify. Netlify to odradza: dochodzi kolejny cache, który trzeba czyścić osobno, edge functions tracą informację o lokalizacji odwiedzającego, a odnawianie certyfikatów może przestać działać. Rekordy strony zostaw w trybie „DNS only”.
- Obsłuż DNSSEC we właściwej kolejności. Jeśli stara strefa jest podpisana, usuń jej rekord DS u rejestratora i odczekaj, aż wygaśnie TTL rekordu DS, zanim przełączysz serwery nazw. U nowego dostawcy najpierw włącz podpisywanie, odczekaj co najmniej najdłuższy TTL w strefie i dopiero wtedy dodaj nowy rekord DS u rejestratora. Dodanie go zbyt wcześnie sprawia, że domena przestaje się rozwiązywać u wszystkich, którzy korzystają z resolwera walidującego.
- Testuj spoza własnej sieci, bo Twój komputer trzyma w cache stare odpowiedzi. Następnie przecrawluj listę starych adresów URL i potwierdź, że każdy zwraca 301 do strony z kodem 200.
Najczęstsze błędy, które widzimy
- Przekierowywanie każdej wycofanej strony na stronę główną.
- Przekierowania, które nigdy nie zadziałają, bo pod tą samą ścieżką nadal istnieje stary plik.
- Dwa zestawy hreflang na tej samej stronie albo wersje alternatywne, które nie odsyłają z powrotem.
- Wszystkie wersje językowe z canonicalem wskazującym wersję angielską.
- Schematy odwołujące się do obrazów lub stron, które nie istnieją.
- Strony renderowane na serwerze bez cache na CDN albo dane konkretnego odwiedzającego zapisane w stronie trzymanej w cache.
- Manifesty agentów opisujące narzędzia, których nigdy nie zbudowano.
- DNS przełączony, zanim nowa strefa była kompletna, albo nieaktualny rekord DS pozostawiony u rejestratora.
Jak to wygląda w praktyce
Według tego playbooka przenieśliśmy naszą własną stronę, marotino.com, z Wix na Astro i Netlify. Dziś obsługuje 19 języków i około 1500 indeksowalnych adresów URL z generowanych map witryny, a strony są trzymane w cache na CDN Netlify i przy każdym wdrożeniu wysyłany jest ping IndexNow.
Dla maszyn publikuje llms.txt i wersje stron w Markdown, udostępnia działający serwer MCP pod /mcp oraz agenta A2A pod /a2a, połączonego z tym samym asystentem co czat na stronie. Ma też narzędzia WebMCP, ai-catalog ARD i rekordy DNS-AID podpisane DNSSEC. Skaner isitagentready.com od Cloudflare przyznaje jej poziom „Agent-Native”, najwyższy w skali.
Po stronie analityki Consent Mode v2 działa zależnie od regionu, a konwersje z leadów są wysyłane po stronie serwera z webhooka formularza.
To samo podejście stosujemy przy stronach klientów, od firm usługowych po sklepy internetowe – zobacz nasze realizacje.
FAQ
Ile trwa migracja z Wix na Astro?
Migracja typowej strony firmowej trwa kilka tygodni od inwentaryzacji do uruchomienia. Najwięcej zależy od liczby stron i języków, ilości treści do przepisania oraz integracji, takich jak CRM, formularze, analityka i czat. Warstwa dla agentów AI dokłada do tego dni, a nie tygodnie.
Czy po odejściu z Wix stracę pozycje w Google?
Nie, jeśli każdy stary URL ma przekierowanie 301 do najbliższego nowego odpowiednika, a treść jest co najmniej tak dobra jak wcześniej. Wahania przez kilka tygodni, gdy Google ponownie crawluje stronę, są normalne. Trwały spadek niemal zawsze wynika z brakujących przekierowań, utraconej treści albo błędnych tagów hreflang i canonical.
Czy mój zespół nadal może edytować treści bez programisty?
Tak. Astro współpracuje z headless CMS-ami oraz z plikami Markdown w Gicie, edytowanymi przez prosty interfejs webowy. Każdą zmianę można obejrzeć w podglądzie, zanim trafi na produkcję.
Czy Netlify jest drogi w porównaniu z Wix?
Dla większości stron firmowych koszty hostingu są na podobnym poziomie lub niższe. Większym kosztem jest sama przebudowa, której cena zależy od zakresu. Nasz przewodnik po kosztach wyjaśnia, co na nią wpływa.
Czym jest llms.txt i czy go potrzebuję?
llms.txt to proponowany plik Markdown w katalogu głównym strony, który podsumowuje firmę i linkuje do jej kluczowych stron, dzięki czemu modele językowe i agenci rozumieją stronę bez crawlowania jej w całości. Nie jest oficjalnym standardem i żadna duża wyszukiwarka nie potwierdziła, że bierze go pod uwagę w rankingu. Wymaga niewiele pracy, więc traktujemy go jako tani dodatek, a nie taktykę rankingową.
Czym jest serwer MCP na stronie internetowej?
MCP (Model Context Protocol) to otwarty protokół, który pozwala asystentom AI korzystać z narzędzi. Serwer MCP na stronie pozwala asystentowi przeszukiwać Twoje usługi i case studies, a gdy użytkownik o to poprosi – wysłać Ci zapytanie przez Twój prawdziwy formularz kontaktowy, bez scrapowania Twoich stron.
Chcesz tego dla swojej strony?
Takie migracje planujemy i realizujemy od początku do końca: inwentaryzacja i przekierowania, projekt, treści, SEO, analityka i warstwa dla agentów AI. Opowiedz nam o swojej stronie, a odezwiemy się z planem.